DEEPSEEK
Public Preview · 深度求索大教堂中枢

探索未至之境
DeepSeek AI 语言模型与推理矩阵

DeepSeek 深度求索以开创性 MoE 混合专家稀疏激活架构与多层长思维链强化学习自省逻辑,在全暗的理性殿堂中投下真理光辉。
全面化解复杂数理推导、全库工程重构与高并发产业智能化挑战,打造坚如石肋、绚如琉璃的前沿基座。

671B 总参数 MoE 架构
37B 单 Token 激活参数
128K 原生上下文窗口
100% MIT 自由开放协议
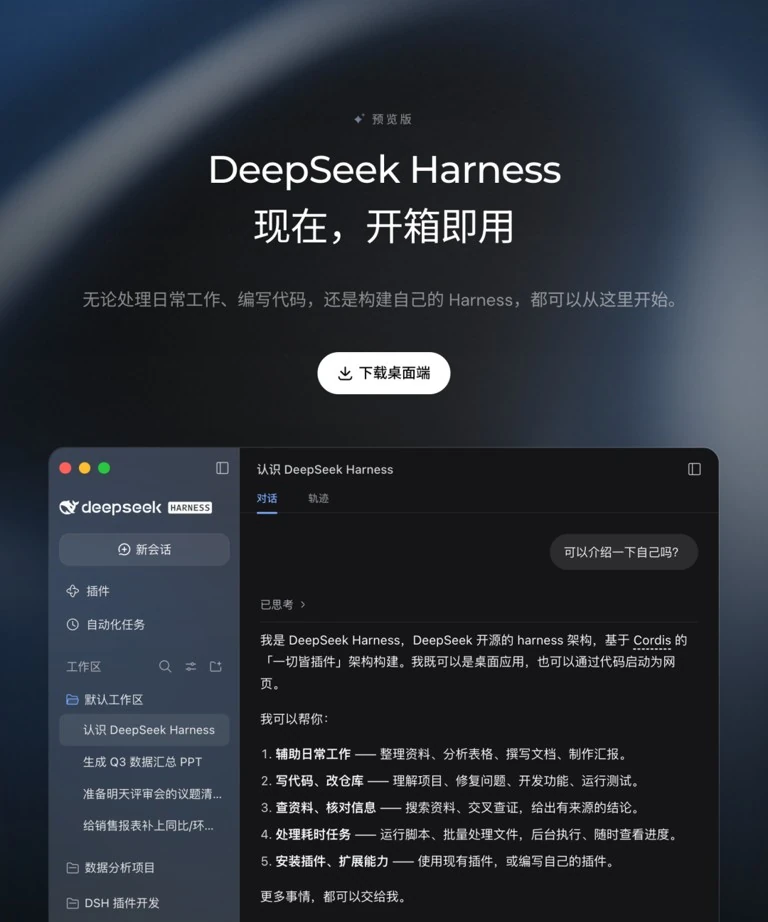
DEEPSEEK WORKBENCH · 真实推理工作台窗格
MODEL: deepseek-r1 STATUS: ILLUMINATED
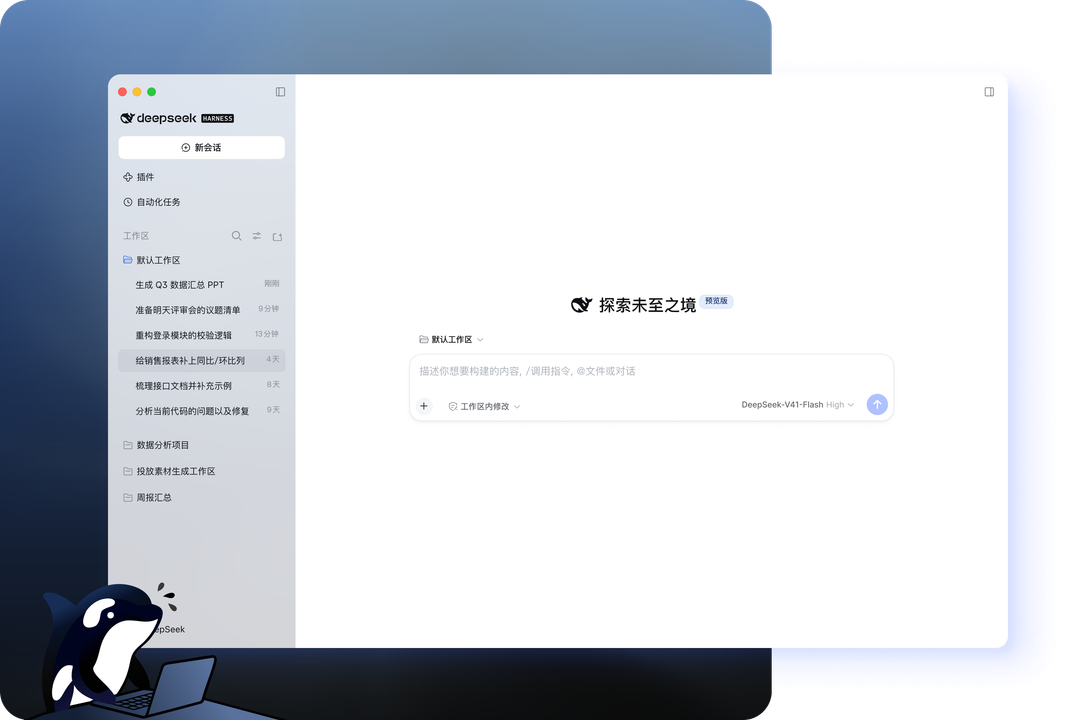
DeepSeek 真实工作台与自省长思维链交互界面展示
LANCET WINDOW · STAGE

真实界面预览:
透明展开的深度思维链

如同光线透过彩色花窗将光影清晰投射于地面,DeepSeek 对话工作台直观呈现长思维链(Chain of Thought)在每一步数理证明、多假设剪枝与代码生成时的真实推理轨迹。

  • ✦ 自省反思可见性:完整展开假设校验与回溯修正切片;
  • ✦ 数理与工程推理:AIME 及 MATH 竞赛级推导逻辑实时验证;
  • ✦ 128K 超长文献理解:整本专著零损失语义检索与结构化提炼。
STAINED GLASS MATRIX

核心特性与架构窗格矩阵

以信息为彩色窗上的分格,深色室内中熠熠生辉的算法与工程突破。

COBALT · ARCHITECTURE PANE · 01

稀疏激活 MoE 与 MLA 潜在注意力

独创的多头潜在注意力(Multi-head Latent Attention, MLA)机制,将 KV 缓存体积大幅缩减至原先的 1/5;在 671B 庞大参数池中仅激活 37B 针对性专家,实现极致能效。
DeepSeek MoE 混合专家稀疏激活架构图
// MLA 潜在注意力显存极简压缩 class MultiHeadLatentAttention(nn.Module): def forward(self, x): compressed_kv = self.kv_down_proj(x) return self.compute_sparse_routing(compressed_kv)
RUBY · MULTI-SCENARIO PANE · 02

跨工程代码重构与结构化 Diff

具备强大的多工程上下文感知力,精准解析软件仓库依赖、自动诊断并发死锁与性能瓶颈,输出符合工业标准的补丁与修复方案。

DeepSeek 多场景复杂任务与代码 Diff 重构展示
--- a/runtime/scheduler.rs +++ b/runtime/scheduler.rs @@ -108,7 +108,7 @@ - pub fn dispatch(req: LegacyRequest) -> Result<()> { + pub fn dispatch(req: DeepSeekInferenceReq) -> Result<StreamResponse> { + telemetry::record_token_latency(req.session_id);
AMETHYST · OBSERVABILITY SLAB · 03

执行轨迹观测与 Harness 自动化流水线

借助 DeepSeek Harness 自动化测试套件与原生可观测性探针,全面监控 Token 吞吐速率、思维链耗时切片、缓存命中比例及分支推导拓扑,每一次智能涌现皆精密可验。

# 启动 Harness 端对端自动化评测流水线 $ deepseek-harness run --task=math500 --model=deepseek-r1 --workers=16 [SUCCESS] Accuracy: 97.3% | P95 Latency: 410ms | Cache Hit: 89.1%
DeepSeek 执行轨迹可观测性与自动化运行面板
ZERO-FRICTION DEPLOYMENT

零摩擦起步 · 本地极速启程

无需复杂安装配置,只需在系统终端轻敲一行指令,即可在本地唤醒 DeepSeek 智能代理中枢。

$ npx deepseek-agent@latest run --model=deepseek-r1
✓ 跨平台运行 (Linux / macOS / Windows) ✓ 100% 兼容 OpenAI SDK 接口规范 ✓ 原生支持长自省思维链与流式传输
COMMUNITY SANCTUARY

开放学术生态与全球贡献者

深信开放的力量,所有核心模型权重、技术报告与评测套件均向全球科研者无保留公开。

MIT 开放许可

商业友好无约束,模型权重与训练代码完全自由分发、修改与部署。

完整学术论文

详尽公开 MLA 注意力、多 Token 预测及强化学习探索策略路线图。

开源生态插件

全面集成 LangChain、LlamaIndex、Ollama、vLLM 与 SGLang 框架。

全球开发者社区

与数以万计的人工智能学者携手共进,探索通用智能未至之境。