稀疏激活 MoE 与 MLA 潜在注意力
独创的多头潜在注意力(Multi-head Latent Attention, MLA)机制,将 KV 缓存体积大幅缩减至原先的 1/5;在 671B 庞大参数池中仅激活 37B 针对性专家,实现极致能效。
DeepSeek 深度求索以开创性 MoE 混合专家稀疏激活架构与多层长思维链强化学习自省逻辑,在全暗的理性殿堂中投下真理光辉。
全面化解复杂数理推导、全库工程重构与高并发产业智能化挑战,打造坚如石肋、绚如琉璃的前沿基座。
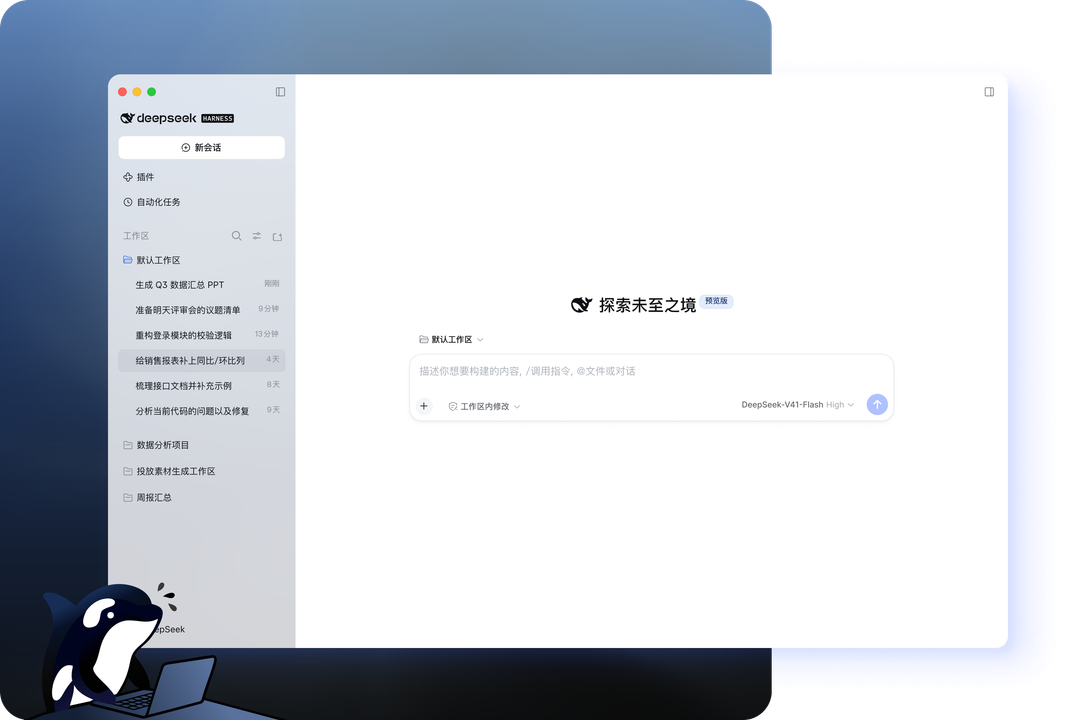
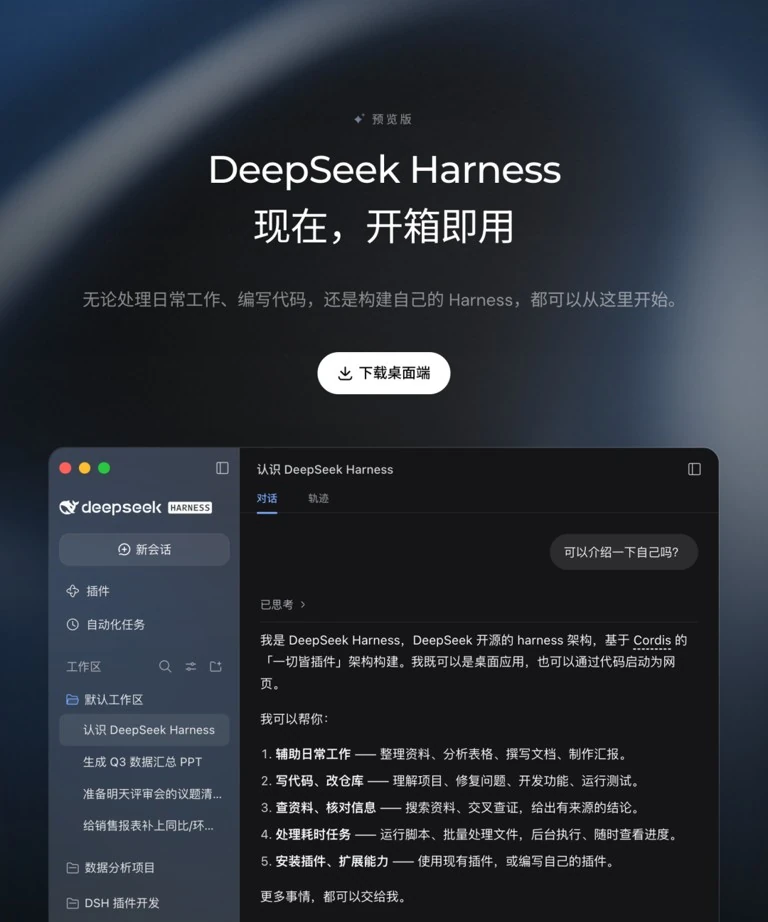
如同光线透过彩色花窗将光影清晰投射于地面,DeepSeek 对话工作台直观呈现长思维链(Chain of Thought)在每一步数理证明、多假设剪枝与代码生成时的真实推理轨迹。
以信息为彩色窗上的分格,深色室内中熠熠生辉的算法与工程突破。
独创的多头潜在注意力(Multi-head Latent Attention, MLA)机制,将 KV 缓存体积大幅缩减至原先的 1/5;在 671B 庞大参数池中仅激活 37B 针对性专家,实现极致能效。
具备强大的多工程上下文感知力,精准解析软件仓库依赖、自动诊断并发死锁与性能瓶颈,输出符合工业标准的补丁与修复方案。
借助 DeepSeek Harness 自动化测试套件与原生可观测性探针,全面监控 Token 吞吐速率、思维链耗时切片、缓存命中比例及分支推导拓扑,每一次智能涌现皆精密可验。
无需复杂安装配置,只需在系统终端轻敲一行指令,即可在本地唤醒 DeepSeek 智能代理中枢。
npx deepseek-agent@latest run --model=deepseek-r1
深信开放的力量,所有核心模型权重、技术报告与评测套件均向全球科研者无保留公开。
商业友好无约束,模型权重与训练代码完全自由分发、修改与部署。
详尽公开 MLA 注意力、多 Token 预测及强化学习探索策略路线图。
全面集成 LangChain、LlamaIndex、Ollama、vLLM 与 SGLang 框架。
与数以万计的人工智能学者携手共进,探索通用智能未至之境。